기존 음성인식 엔진을 바꾸지 않고 인식률만 높일 수 있나요?
인식 엔진은 그대로 두고 마이크와 엔진 사이에 전처리를 넣으면 됩니다. 엔진을 바꿔도 현장 인식률이 그대로인 이유, 재학습이 필요 없는 조건과 필요해지는 조건, 같은 엔진으로 전후를 비교해 효과를 확인하는 방법을 정리했습니다.
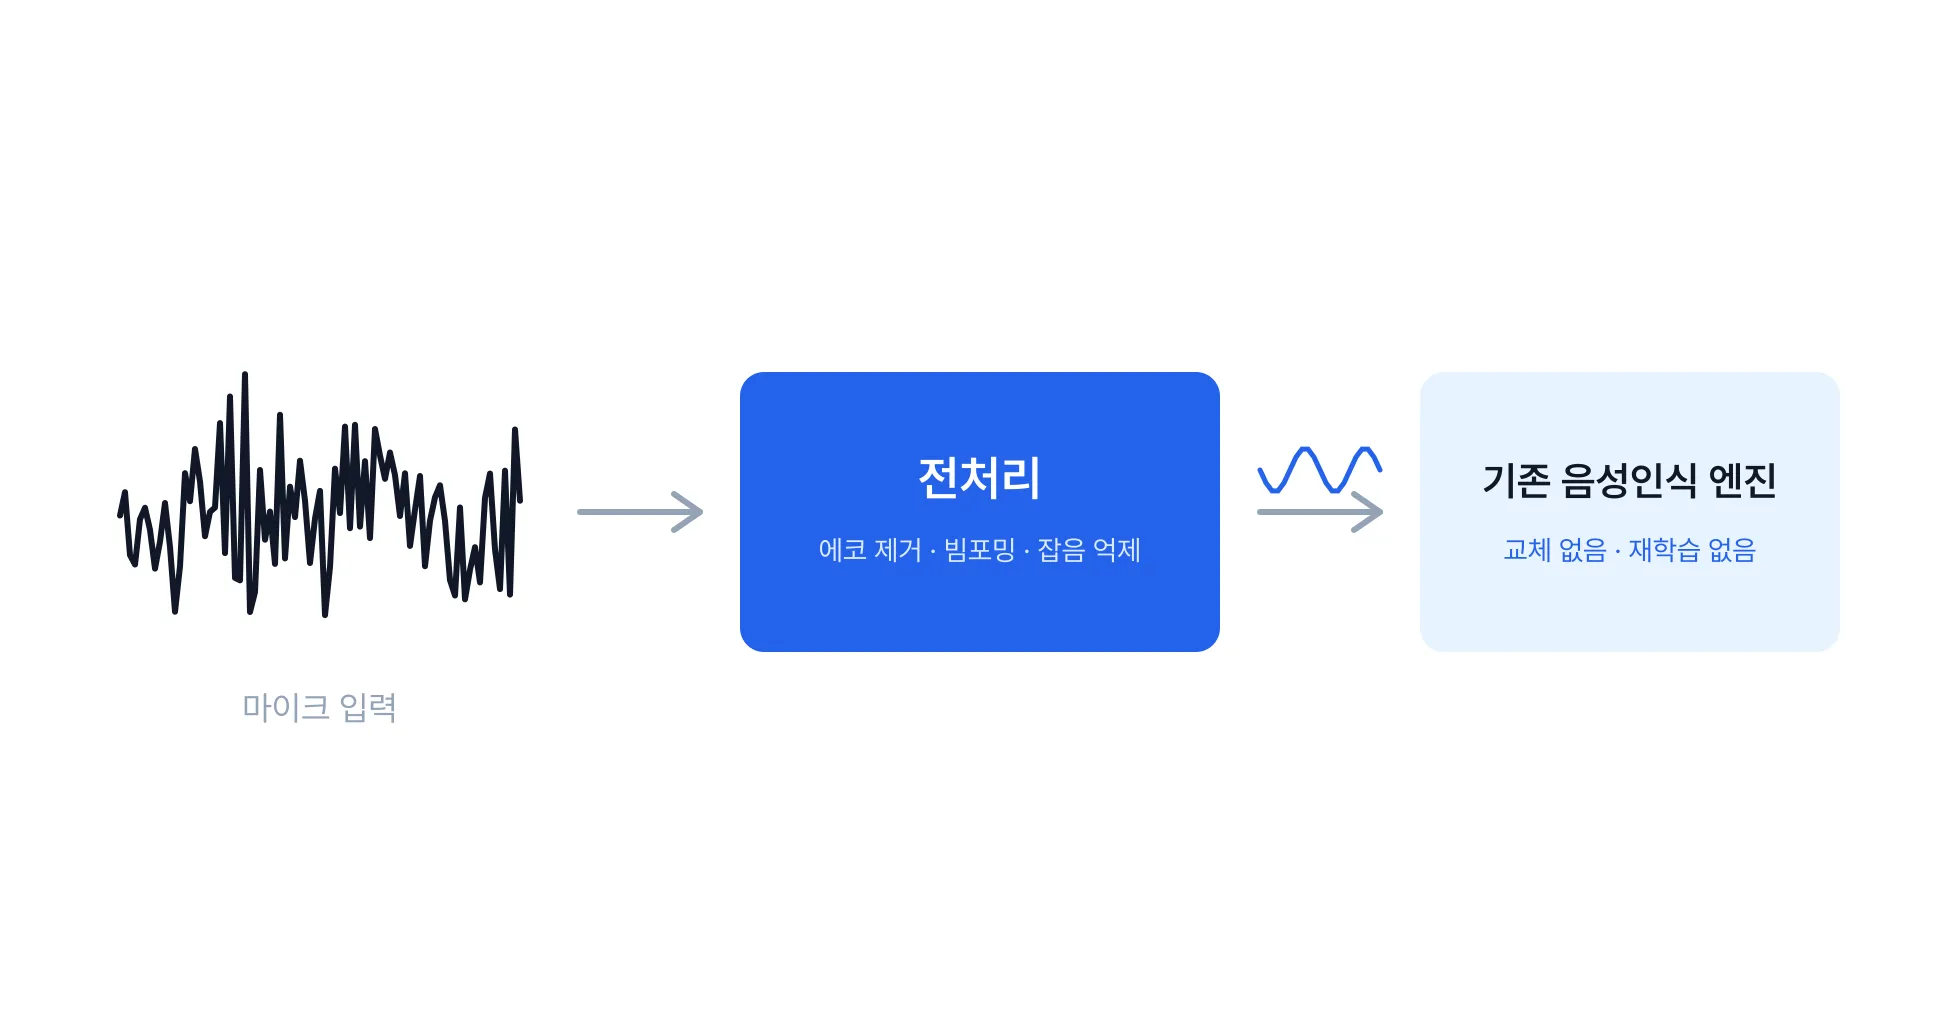

네. 인식 엔진은 그대로 두고, 마이크와 엔진 사이에 전처리를 넣어 엔진이 받는 신호를 바꾸는 방법입니다. 엔진을 교체하거나 재학습하지 않아도 되는 이유는, 전처리가 엔진의 입력 형식은 건드리지 않고 그 안에 섞인 잡음·에코·잔향만 걷어내기 때문입니다.
이 글은 왜 엔진을 바꿔도 현장 인식률이 그대로인지, 전처리가 어디에 들어가는지, 재학습이 필요 없는 조건과 필요해지는 조건, 그리고 효과를 어떻게 확인하는지를 순서대로 답합니다.
음성인식 모델을 바꿨는데도 실제 환경에서 성능이 좋아지지 않는 이유는?
인식 엔진의 벤치마크는 대개 깨끗한 음성으로 잽니다. 현장의 입력은 다릅니다 — 매장의 배경음악, 제품 스피커의 안내음이 되돌아온 에코, 벽에 부딪혀 늦게 도착하는 잔향, 두세 걸음 떨어진 곳에서 오는 작은 소리가 한꺼번에 들어옵니다. 잡음 환경에서 인식률이 떨어지는 것은 특정 엔진의 약점이 아니라 모든 엔진이 마주하는 공통의 벽이고, 그 벽을 넘는 방법이 오래전부터 따로 연구돼 온 이유입니다 [1].
그래서 엔진 A를 B로 바꿔도 입력이 같으면 같은 벽에 부딪힙니다. 조용한 데서는 잘 되는데 현장에서만 떨어진다면, 문제는 엔진이 아니라 엔진에 들어가는 신호 쪽에 있을 가능성이 큽니다. 홈 화면의 「음성인식 엔진의 문제가 아닐 수도 있습니다」가 말하는 것이 이것입니다.
전처리는 엔진의 어디에 들어가는가
마이크와 엔진 사이입니다. 마이크 → 전처리(에코 제거 → 빔포밍 → 잡음 억제) → 인식 엔진의 순서이고, 엔진 입장에서는 마이크가 좋아진 것과 같습니다. 전처리의 출력은 엔진이 원래 받던 것과 같은 형식의 음성 신호라, 맞출 것은 샘플링 주파수와 채널 수 정도입니다. 이 단계가 무엇을 하고 무엇을 하지 않는지는 음성 전처리란 무엇인가에 정리돼 있습니다.
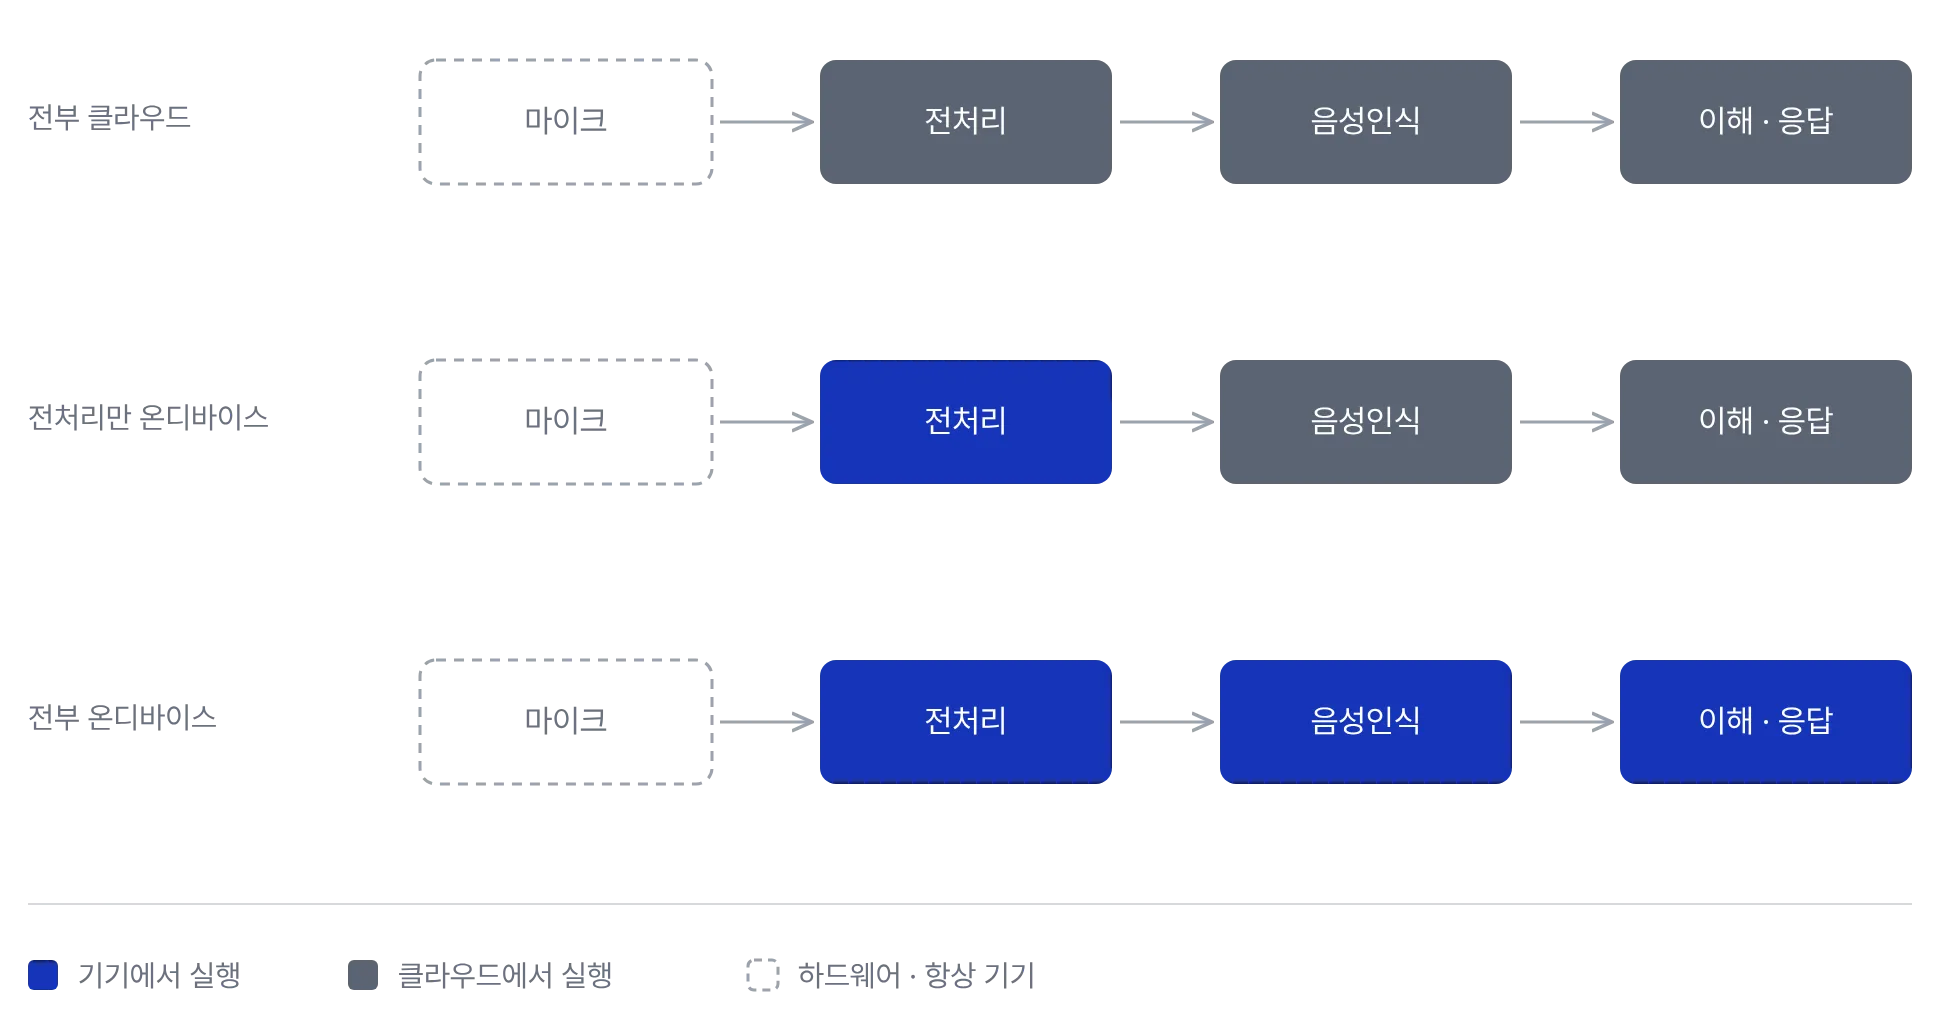
엔진이 클라우드 API여도 마찬가지입니다. 전처리는 기기 안에서 돌고, 정리된 음성만 API로 올라갑니다. 기기와 클라우드를 어떻게 나눌지는 온디바이스와 클라우드 글에서 다뤘습니다.
전처리를 추가하면 기존 음성인식 엔진을 재학습해야 하나요?
아니요 — 단, 전처리가 목표 음성을 왜곡하지 않는다는 조건에서 그렇습니다. 잡음을 세게 눌러 사람 귀에 깨끗하게 만든 신호는 엔진에게 오히려 낯선 입력이 될 수 있습니다. 전처리가 남긴 왜곡과 인공물이 인식 오류를 늘린다는 것은 실험으로 확인된 사실이고 [2], 그때 엔진을 그 왜곡에 맞춰 다시 학습시키고 싶은 유혹이 생깁니다. 재학습이 필요해지는 것은 전처리 때문이 아니라 ‘왜곡하는’ 전처리 때문입니다.
mpAB는 잡음을 선별적으로 제거해 목표 음성의 왜곡을 억제하도록 설계됐습니다. 엔진이 학습한 음성의 모양을 유지한 채 잡음과 에코만 빠지므로, 고객이 보유한 음성인식 모델을 교체하거나 재학습하지 않고 성능만 올리는 것이 이 기술의 목표입니다. 원리는 mpAB에 있습니다.
재학습이 정말 필요한 경우는 따로 있습니다. 엔진이 제품의 도메인 단어(메뉴 이름, 부품 번호, 사내 용어) 자체를 모를 때입니다. 그것은 입력 신호의 문제가 아니라 엔진의 어휘 문제라, 전처리로는 풀리지 않고 엔진 쪽의 적응이 필요합니다.
| 증상 | 원인은 어디인가 | 무엇을 바꾸나 |
|---|---|---|
| 조용한 곳에서는 되는데 현장에서만 떨어진다 | 입력 신호(잡음·에코·잔향) | 전처리를 넣는다. 엔진은 그대로 |
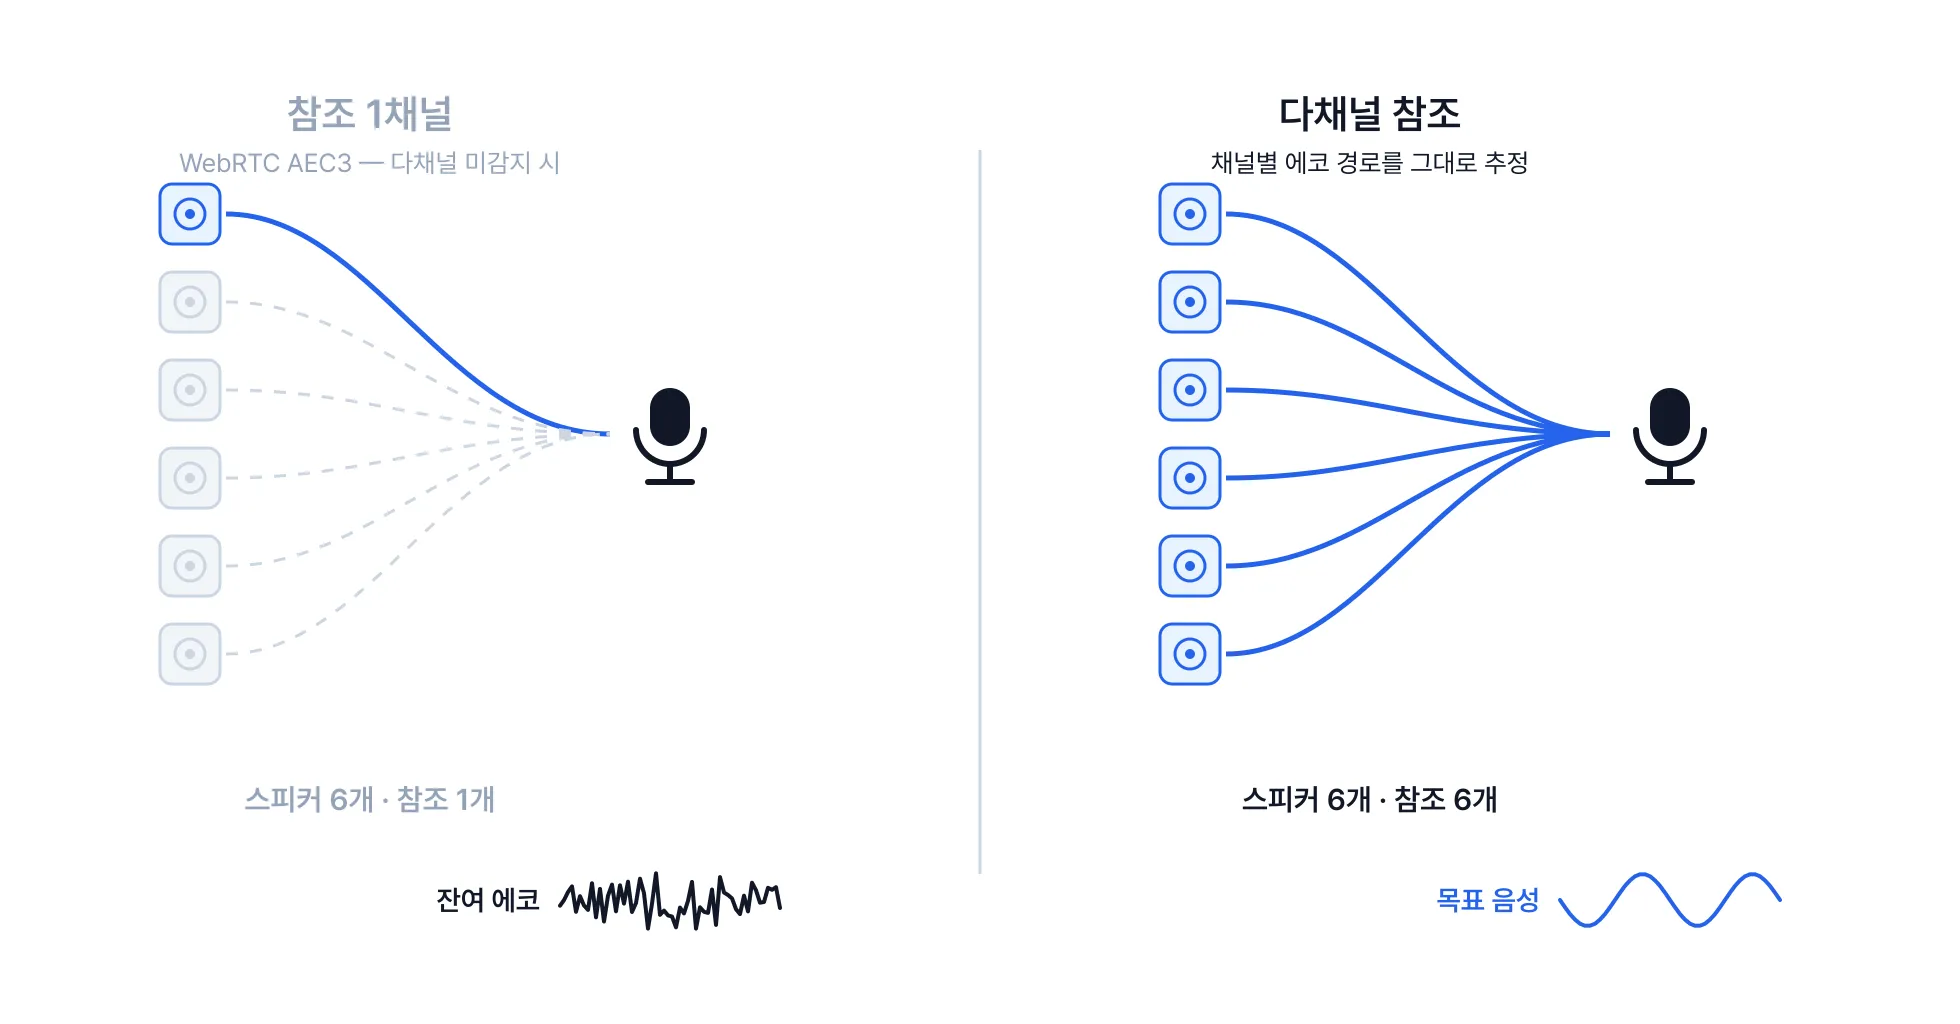
| 제품 스피커가 켜져 있을 때만 오작동한다 | 에코 | 참조 채널을 받는 에코 제거 |
| 조용한 곳에서도 특정 단어를 계속 틀린다 | 엔진의 어휘·언어모델 | 엔진 쪽 적응. 전처리로는 안 풀린다 |
| 여러 사람이 동시에 말할 때만 무너진다 | 발화 겹침 | 음성 분리를 앞단에 둔다 |
상용 API 엔진에도 붙일 수 있는가
네. 상용 API든 제품에 맞춰 개발한 자체 엔진이든 전처리는 그 앞에 놓입니다. API는 보내는 음성의 내용을 따지지 않으므로, 기기에서 정리한 음성을 올리는 것으로 끝입니다. 자체 엔진이라면 입력 파이프라인의 한 단계로 붙입니다. 어느 쪽이든 엔진의 파라미터와 모델 파일은 건드리지 않습니다.
효과는 어떻게 확인하는가
같은 엔진, 같은 녹음으로 전처리 전과 후를 비교합니다. 엔진을 바꾸지 않았기 때문에 차이는 전처리의 몫으로만 남고, 그것이 이 방식의 가장 큰 장점입니다 — 효과를 따로 잴 수 있습니다. 지표는 단어 오류율(WER)이나 문자 오류율(CER), 명령 성공률처럼 엔진의 출력에서 바로 나오는 값을 쓰고, 어떤 수치든 녹음 조건(잡음 종류·SNR·마이크·거리)을 함께 적습니다. 제3자 시험 조건이 붙은 실측값은 기술 페이지의 성능 표에, 지표를 읽는 방법은 성능 지표 읽는 법에 있습니다. 진행 순서는 PoC 절차를 따릅니다.
어떤 조건에서는 전처리로 해결되지 않는가
엔진이 단어 자체를 모르는 경우는 위에서 말했습니다. 그 밖에 입력이 이미 손실 압축이나 클리핑으로 망가진 녹음, 마이크가 포화될 만큼 큰 소음, 스피커 신호를 참조 채널로 받을 수 없는 하드웨어에서는 전처리가 할 수 있는 일이 줄어듭니다. 여러 사람이 동시에 말하는 겹침은 잡음 제거가 아니라 음성 분리의 영역입니다. 이런 조건은 첫 통화에서 대부분 가려지고, 가려지지 않으면 실제 녹음으로 확인합니다.
자주 묻는 질문
전처리를 넣으면 엔진 설정을 바꿔야 하나요?
엔진의 모델과 파라미터는 그대로입니다. 맞출 것은 전처리 출력과 엔진 입력의 샘플링 주파수·채널 수·프레임 길이 정도이고, 이것은 통합 단계에서 한 번 정합니다.
여러 엔진을 비교 중인데 전처리를 먼저 넣어도 되나요?
오히려 그 순서가 공정합니다. 같은 전처리 뒤에서 엔진들을 비교해야 현장 조건에서의 차이가 드러나고, 전처리 없이 비교하면 잡음이 모든 엔진의 점수를 함께 끌어내려 차이가 가려집니다.
전처리 효과가 없으면 어떻게 되나요?
엔진을 건드리지 않았으므로 원래 시스템이 그대로 남습니다. PoC는 그 상태에서 끝나고, 효과가 없는 이유(엔진 어휘, 녹음 품질, 참조 채널 부재 등)를 함께 정리해 드립니다.
참고자료
- [1] J. Li, L. Deng, Y. Gong, and R. Haeb-Umbach, 「An Overview of Noise-Robust Automatic Speech Recognition」, IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 22, no. 4, 2014
- [2] K. Iwamoto, T. Ochiai, M. Delcroix, R. Ikeshita, H. Sato, S. Araki, and S. Katagiri, 「How Bad Are Artifacts?: Analyzing the Impact of Speech Enhancement Errors on ASR」, Interspeech, 2022