회의실 소음과 겹친 발화 때문에 회의록 인식률이 떨어지는 이유는?
두 사람이 동시에 말하면 음성인식 엔진에는 ‘한 사람의 목소리’가 아닌 신호가 들어갑니다. 회의록 인식률이 떨어지는 이유와, 음성 분리 → 화자 구분 → 인식 순서로 앞단을 바꾸는 방법을 시연 영상과 함께 설명합니다.
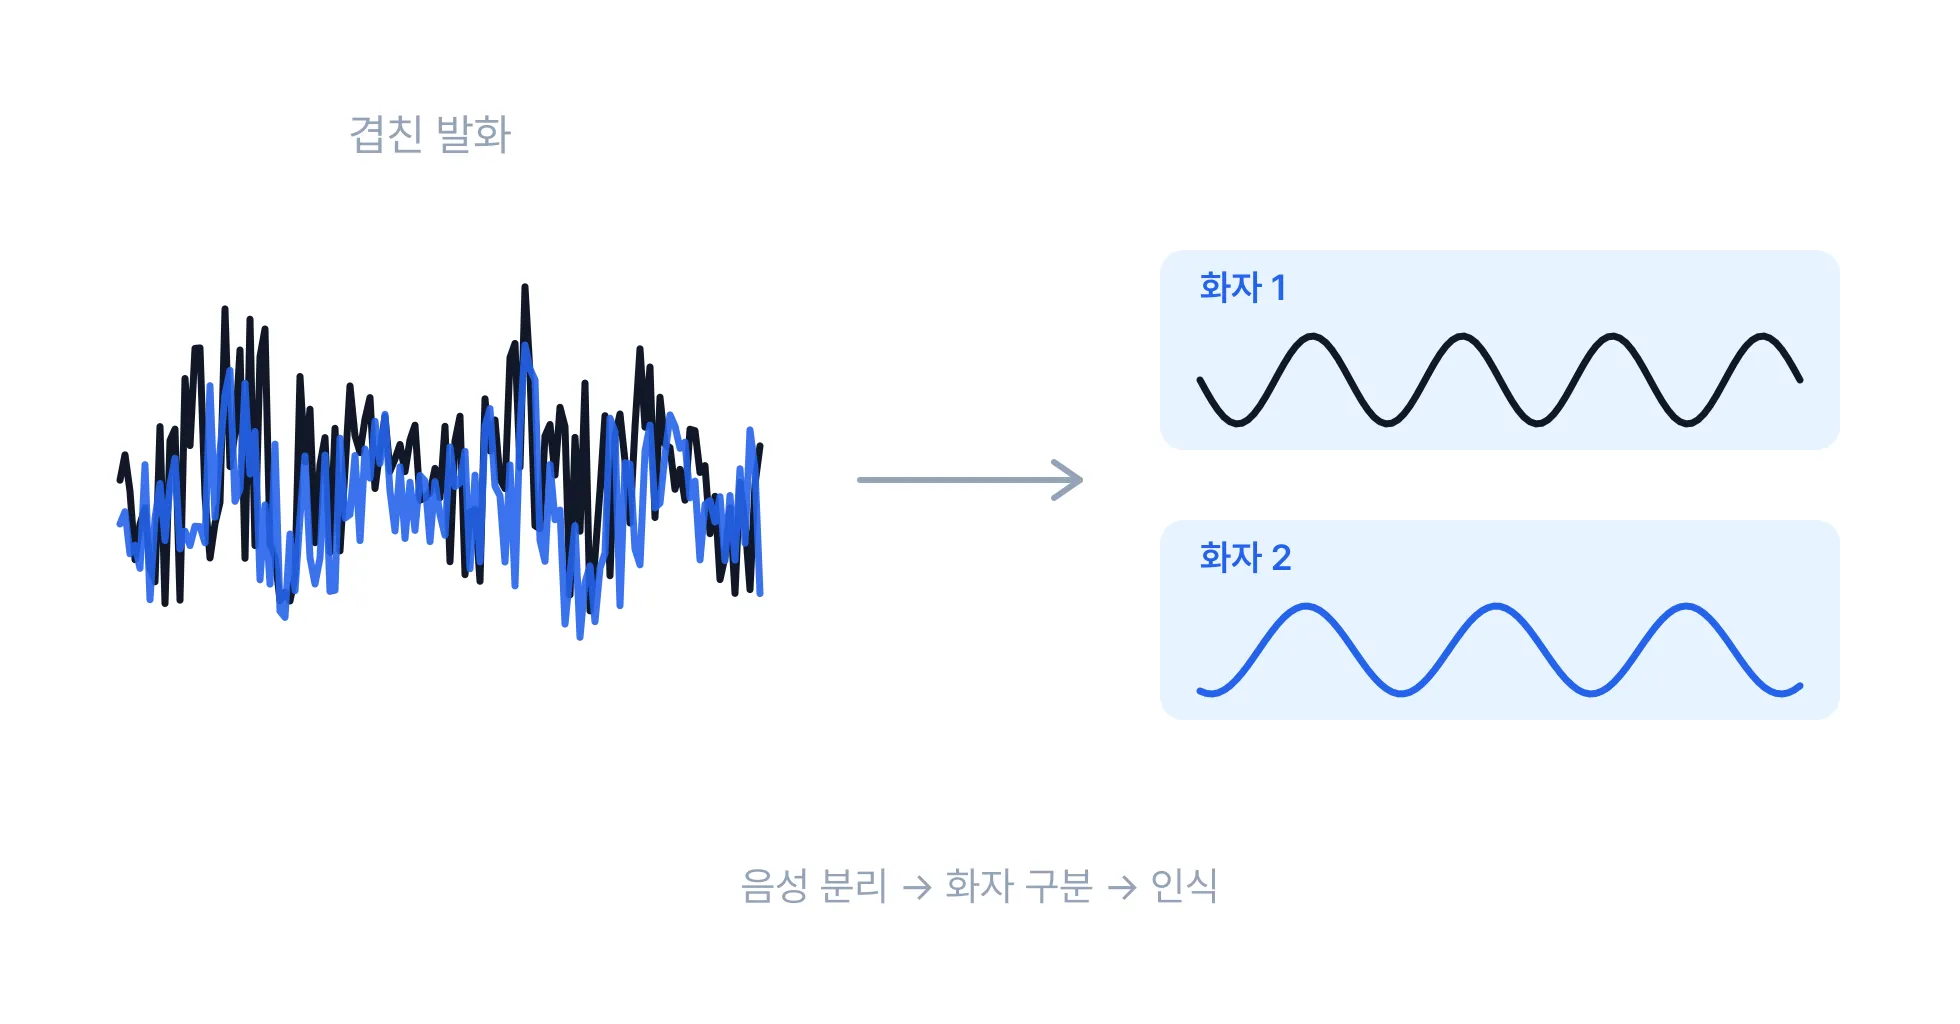

두 사람이 동시에 말하는 순간, 음성인식 엔진에는 한 사람의 말을 받도록 만들어진 입력에 두 사람의 말이 섞여 들어와 둘 다 놓치게 되고, 회의실의 공조·프로젝터·복도 소음은 그 위에 얹혀 남은 음절까지 흐립니다. 회의록 인식률이 떨어지는 이유는 엔진이 약해서가 아니라, 엔진에 들어가는 신호가 이미 ‘한 사람의 목소리’가 아니기 때문입니다.
그래서 해법은 엔진 교체가 아니라 그 앞단에 있습니다. 겹친 발화를 화자별로 나누고(음성 분리), 누가 언제 말했는지 표시한 뒤(화자 구분), 그 결과를 인식 엔진에 넣는 순서입니다. 이 글은 왜 그런지와, 그 순서가 실제 소음·겹침 환경에서 어떻게 동작하는지를 시연 영상과 함께 보여 드립니다.
회의실에서 여러 사람이 동시에 말하면 음성인식이 어려운 이유는?
음성인식 엔진은 한 번에 한 사람이 말하는 음성으로 학습되고 튜닝됩니다. 두 사람의 말이 겹친 구간은 두 음성 파형의 합이라, 엔진이 기대하는 음소의 경계가 사라지고 어느 쪽 문장에도 맞지 않는 결과가 나옵니다. 사람은 여러 사람이 동시에 말하는 자리에서도 한 사람의 말을 골라 듣습니다 — 1953년에 ‘칵테일파티 효과’로 이름 붙은 능력입니다 [1]. 그러나 마이크 하나가 받은 신호에는 그 ‘고르기’가 없습니다. 섞인 채로 들어옵니다.
회의에서 겹침은 드문 일이 아닙니다. 짧은 맞장구, 말을 자르고 들어오는 반박, 두 사람이 동시에 답하는 순간이 대화 곳곳에 있고, 다자간 회의 녹음에서 겹친 발화가 얼마나 흔한지는 오래전부터 관찰돼 왔습니다 [2]. 겹침 구간의 오류는 그 구간에서 끝나지 않습니다. 인식 엔진의 언어모델이 앞뒤 문맥으로 단어를 고르기 때문에, 망가진 몇 음절이 앞뒤 문장의 단어 선택까지 흔듭니다.
회의실 소음은 왜 잡음 제거만으로 해결되지 않는가
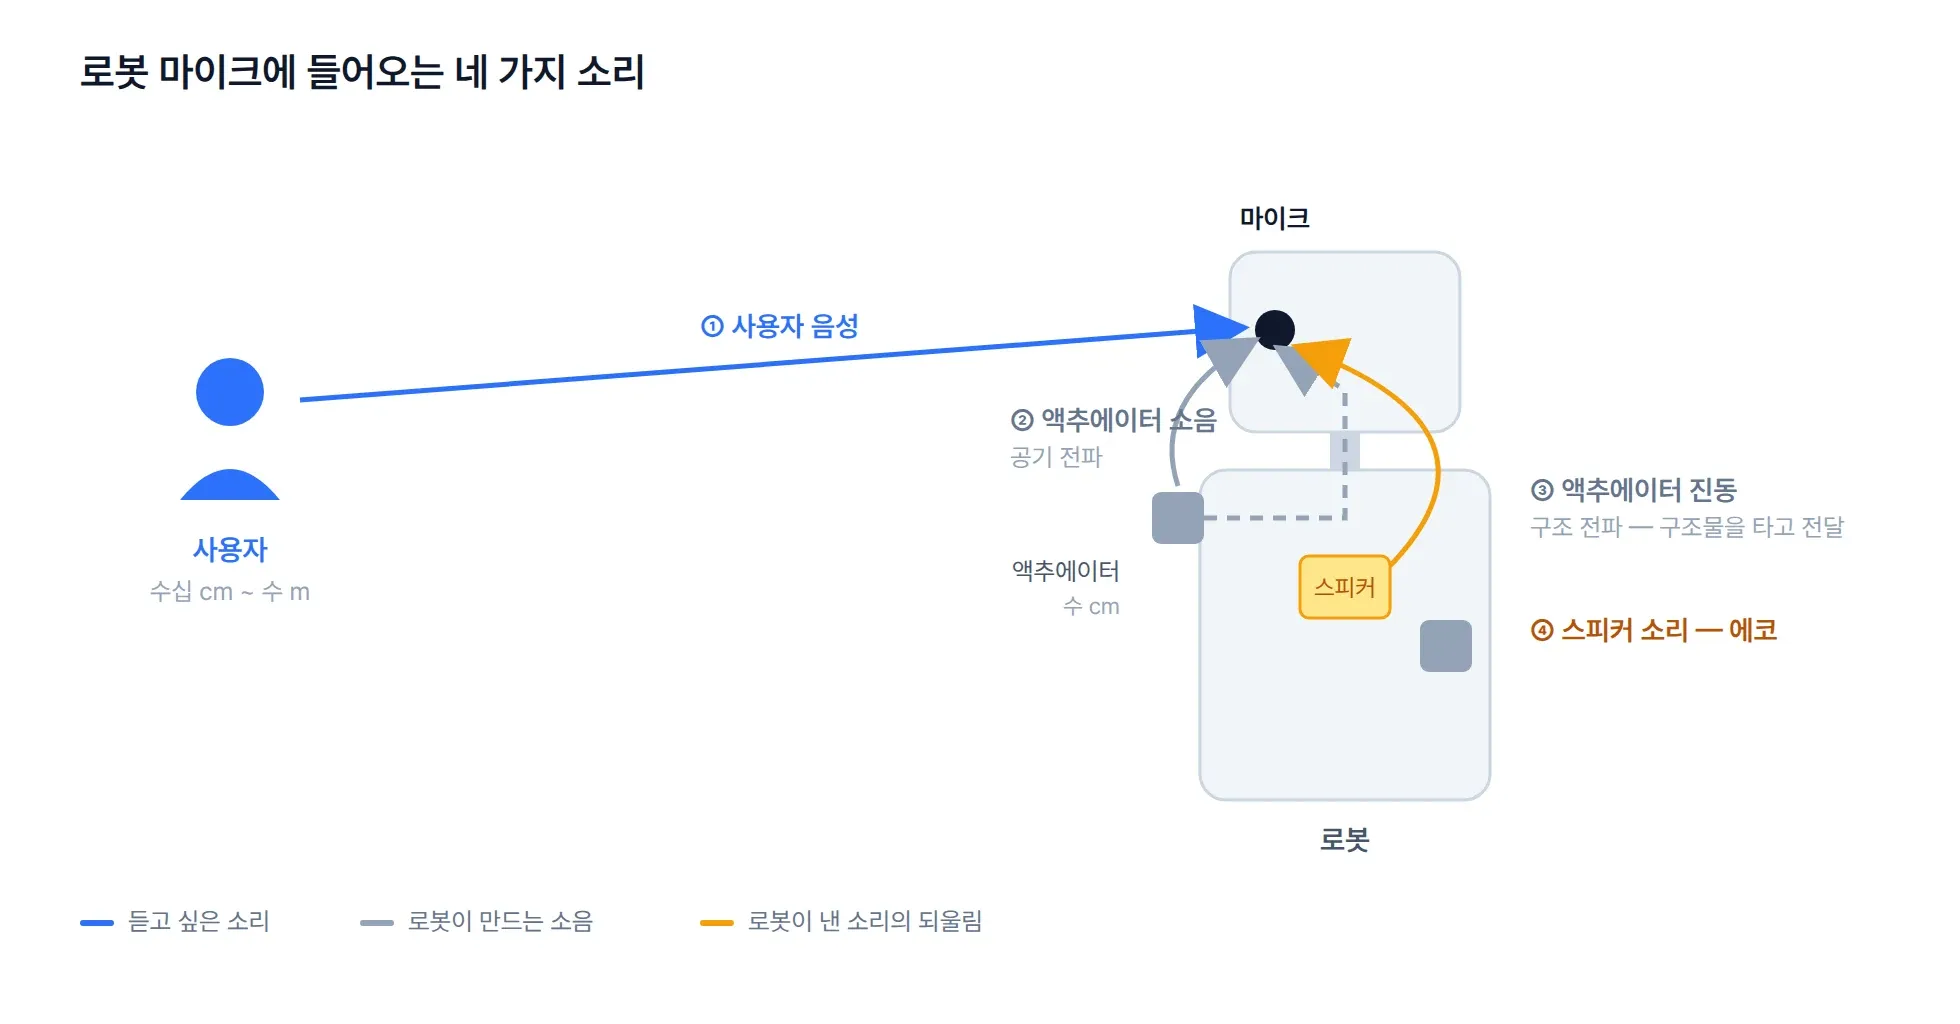
잡음 제거는 ‘음성인가, 음성이 아닌가’를 가릅니다. 공조 소음, 노트북 팬, 복도의 발소리는 음성이 아니라서 걷어낼 수 있습니다. 그러나 겹친 발화는 둘 다 음성입니다. 잡음 제거가 손댈 수 있는 대상이 아닙니다. 게다가 잡음을 세게 눌러 사람 귀에 깨끗하게 만든 신호가 인식 엔진에는 오히려 낯선 입력이 되는 경우가 있습니다 — 목표 음성까지 함께 깎여 학습 분포에서 벗어나기 때문입니다. 잡음 제거 강도가 곧 인식률이 아닌 이유입니다.
회의실에는 소음 말고도 두 가지가 더 있습니다. 긴 테이블과 유리벽이 만드는 잔향, 그리고 테이블 중앙의 마이크 하나가 여러 자리의 화자를 멀리서 받아야 하는 원거리 조건입니다. 그래서 회의록 문제는 셋으로 나누어 풀어야 합니다 — 소음과 잔향은 전처리가, 겹침은 음성 분리가, 누가 말했는지는 화자 구분이 맡습니다.
겹쳐 말하는 음성도 각각 분리해 STT할 수 있나요?
네. mpSeparation이 겹친 음성을 화자별 채널로 실시간 분리합니다. 분리된 채널 하나하나는 ‘한 사람의 목소리’이므로, 그대로 음성인식에 넣으면 겹침 구간도 각자의 문장으로 나옵니다. 아래 영상은 주변 잡음과 발화 겹침이 함께 있는 연속 발화를 화자별로 나누는 과정을 보여 줍니다.
분리는 ‘누구의 목소리인가’를 가르는 일이지 ‘무슨 말인가’를 알아듣는 일이 아닙니다. 그래서 분리 뒤에도 인식 엔진은 그대로 필요합니다 — 다만 이제는 엔진이 기대하는 모양의 입력을 받습니다.
분리한 다음에는 무엇이 필요한가 — 화자 구분과 인식
회의록이 되려면 문장에 ‘누가, 언제’가 붙어야 합니다. 그 일은 mpDiarization이 합니다. 분리된 음성을 시간축 위에 화자 라벨(화자 1·화자 2…)과 발화 구간으로 정리합니다 [3]. 화자 구분은 목소리를 ‘가르는’ 것이지 ‘누구인지 아는’ 것이 아닙니다. 이름을 붙이려면 참석자 등록처럼 회의 시스템 쪽 기능과 결합해야 하고, 그 단계에는 사용 목적과 동의 절차가 따릅니다.
| 순서 | 하는 일 | 출력 | mpWAV |
|---|---|---|---|
| ① 전처리 | 공조·팬 소음과 스피커 에코, 잔향의 영향을 줄인다 | 깨끗해진 다채널 음성 | mpAB |
| ② 음성 분리 | 겹친 발화를 화자별 채널로 나눈다 | 화자별 음성 | mpSeparation |
| ③ 화자 구분 | 누가 언제 말했는지 시간 구간으로 표시한다 | 화자 라벨 + 구간 | mpDiarization |
| ④ 인식 | 채널별 음성을 텍스트로 옮긴다 | 화자별 텍스트 | mpASR 또는 기존 엔진 |
④의 인식 엔진은 바꾸지 않아도 됩니다. 이미 쓰는 STT 서비스나 자체 엔진 앞에 ①~③을 두면, 엔진이 받는 것은 ‘한 사람씩, 잡음이 걷힌’ 음성이 됩니다. 엔진을 그대로 두고 앞단만 바꾸는 이유와 조건은 기술 페이지의 FAQ에 정리돼 있습니다.
어떤 조건에서는 잘 되지 않는가
회의록 구성이 어려워지는 조건을 먼저 밝혀 두는 편이 정직합니다. 동시에 말하는 사람 수가 마이크 채널 수를 크게 넘어서면 분리가 어려워집니다. 마이크가 하나뿐이고 화자까지 멀며 잔향이 길면, 방향 정보가 없어 분리와 화자 구분의 정확도가 함께 떨어집니다. 녹음이 이미 손실 압축이나 자동 이득 조절로 뭉개져 있으면 앞단이 할 수 있는 일이 줄어듭니다. 거의 전 구간이 겹치는 격론 같은 회의는 분리해도 문장 자체가 짧게 끊깁니다.
이 조건들은 회의실마다 다르게 나타나기 때문에, 우리는 성능을 하나의 숫자로 약속하지 않습니다. 대신 실제 회의 녹음으로 전후를 비교합니다.
회의록 프로젝트는 어떻게 시작하는가
실제 회의 녹음이 있으면 그것으로 시작합니다. 없으면 회의실 크기, 참석자 수, 마이크 위치를 함께 정해 테스트 조건을 만듭니다. 테이블 중앙에는 360° 전방위를 받는 원형 어레이가 맞고, 마이크 2~8개 범위에서는 개수와 배치가 바뀌어도 알고리즘을 다시 맞출 필요가 없어 회의실마다 다른 설치 조건에 대응할 수 있습니다. 진행 순서와 산출물은 PoC 절차에, 첫 통화에서 묻는 열두 가지는 PoC 전 체크리스트에 있습니다.
자주 묻는 질문
회의록에 마이크는 몇 개가 필요한가요?
테이블 중앙에 두는 원형 어레이는 MEMS 마이크 최대 7채널로 360° 전방위를 받습니다. 마이크 2~8개 범위에서는 개수와 배치가 바뀌어도 재튜닝이 필요 없습니다. 마이크가 하나뿐이면 mpNC로 잡음은 줄일 수 있지만 방향 정보가 없어 분리와 화자 구분의 정확도는 여러 개일 때보다 떨어집니다.
화자 이름까지 붙일 수 있나요?
화자 구분은 ‘화자 1·화자 2’처럼 목소리를 가르는 것이고, 이름은 참석자 등록처럼 회의 시스템 쪽 기능과 결합해야 붙습니다. 그 단계는 개인 식별에 해당하므로 사용 목적과 동의 절차를 도입 시 함께 확인합니다.
이미 쓰는 회의록 서비스에 붙일 수 있나요?
네. 전처리·음성 분리·화자 구분은 인식 엔진 앞단에서 동작하고, 결과를 기존 STT 서비스나 자체 엔진에 그대로 넘깁니다. 엔진을 바꾸지 않으므로 같은 녹음으로 전후를 비교해 효과를 따로 확인할 수 있습니다.
참고자료
- [1] E. C. Cherry, 「Some Experiments on the Recognition of Speech, with One and with Two Ears」, The Journal of the Acoustical Society of America, vol. 25, no. 5, 1953
- [2] E. Shriberg, A. Stolcke, and D. Baron, 「Observations on Overlap: Findings and Implications for Automatic Processing of Multi-Party Conversation」, Eurospeech, 2001
- [3] T. J. Park, N. Kanda, D. Dimitriadis, K. J. Han, S. Watanabe, and S. Narayanan, 「A Review of Speaker Diarization: Recent Advances with Deep Learning」, Computer Speech & Language, vol. 72, 2022