음성 전처리란 무엇인가? — 인식 엔진 앞단에서 벌어지는 일
음성 전처리는 마이크 신호가 인식 엔진에 닿기 전에 잡음·반향·에코를 걷어내 목표 화자의 음성만 남기는 단계입니다. 엔진과 무엇이 다른지, 에코 제거·빔포밍·잡음 억제 세 기술이 어떻게 구성되는지, 이미 만든 시스템에 어떻게 붙는지를 정리한 정의 글입니다.

음성 전처리는 마이크로 들어온 신호가 음성인식 엔진에 도달하기 전에 잡음·반향·에코를 걷어내 목표 화자의 음성만 남기는 단계입니다. 인식 엔진이 무엇을 알아듣느냐가 아니라 엔진에 무엇이 들어가느냐를 다루는 기술이고, 그래서 엔진을 바꾸지 않고도 현장 인식률을 바꿀 수 있는 자리입니다.
이 글은 사이트 전체에서 ‘음성 전처리’라는 말이 처음 나올 때 돌아오는 정의 글입니다. 전처리가 엔진과 어떻게 다른지, 어떤 기술로 이루어지는지, 어디에서 실행되는지, 이미 만든 시스템에는 어떻게 붙는지를 답합니다.
음성 전처리란 무엇인가
음성 전처리(speech preprocessing)는 마이크 입력에서 목표 화자의 음성을 보존한 채 잡음·에코·잔향의 영향을 줄여, 뒤에 오는 음성인식 엔진이 기대하는 모양의 신호를 만들어 주는 처리 단계입니다.
핵심은 ‘보존한 채’에 있습니다. 소음을 세게 누르는 것은 어렵지 않습니다. 어려운 것은 그러면서 목표 음성을 깎지 않는 것입니다. 사람 귀에 깨끗하게 들리도록 만든 신호가 인식 엔진에는 오히려 낯선 입력이 될 수 있어서, 음성인식을 위한 전처리는 청취 품질이 아니라 인식률을 기준으로 설계합니다 [1].
음성 전처리와 음성인식 엔진은 무엇이 다른가요?
전처리는 신호를 다루고, 엔진은 말을 다룹니다. 전처리의 입력과 출력은 둘 다 음성 신호입니다 — 들어온 것보다 깨끗한 신호가 나갈 뿐 형식은 같습니다. 엔진의 입력은 음성 신호이고 출력은 텍스트입니다. 전처리는 ‘무슨 말인지’를 전혀 모릅니다. 어느 방향에서 왔는지, 스피커에서 나간 소리가 되돌아온 것인지, 음성인지 기계음인지를 물리·통계적 단서로 가를 뿐입니다.
| 구분 | 음성 전처리 | 음성인식 엔진 |
|---|---|---|
| 입력 → 출력 | 음성 신호 → 음성 신호 | 음성 신호 → 텍스트 |
| 다루는 것 | 잡음·에코·잔향·방향 | 음소·단어·문맥 |
| 단서 | 마이크 간 시간차, 참조 신호, 통계적 성질 | 음향 모델, 언어모델, 어휘 |
| 실행 위치 | 대개 기기 안(온디바이스) | 기기 또는 클라우드 |
| 바꾸면 생기는 일 | 엔진은 그대로, 입력만 달라진다 | 어휘·언어·응답이 달라진다 |
전처리 없이 인식 엔진만 바꾸면 왜 한계가 있는가
잡음 속에서 인식률이 떨어지는 것은 모든 엔진이 공유하는 벽이라, 엔진을 바꿔도 입력이 같으면 같은 벽에 부딪힙니다 [1]. 조용한 곳에서는 되는데 현장에서만 안 된다면 원인은 대개 입력 쪽에 있습니다. 엔진을 두고 앞단을 바꾸는 방법과 그 조건은 기존 음성인식 엔진을 바꾸지 않고 인식률만 높일 수 있나요?에서 따로 다룹니다.
음성인식 전처리에는 어떤 기술들이 필요한가요?
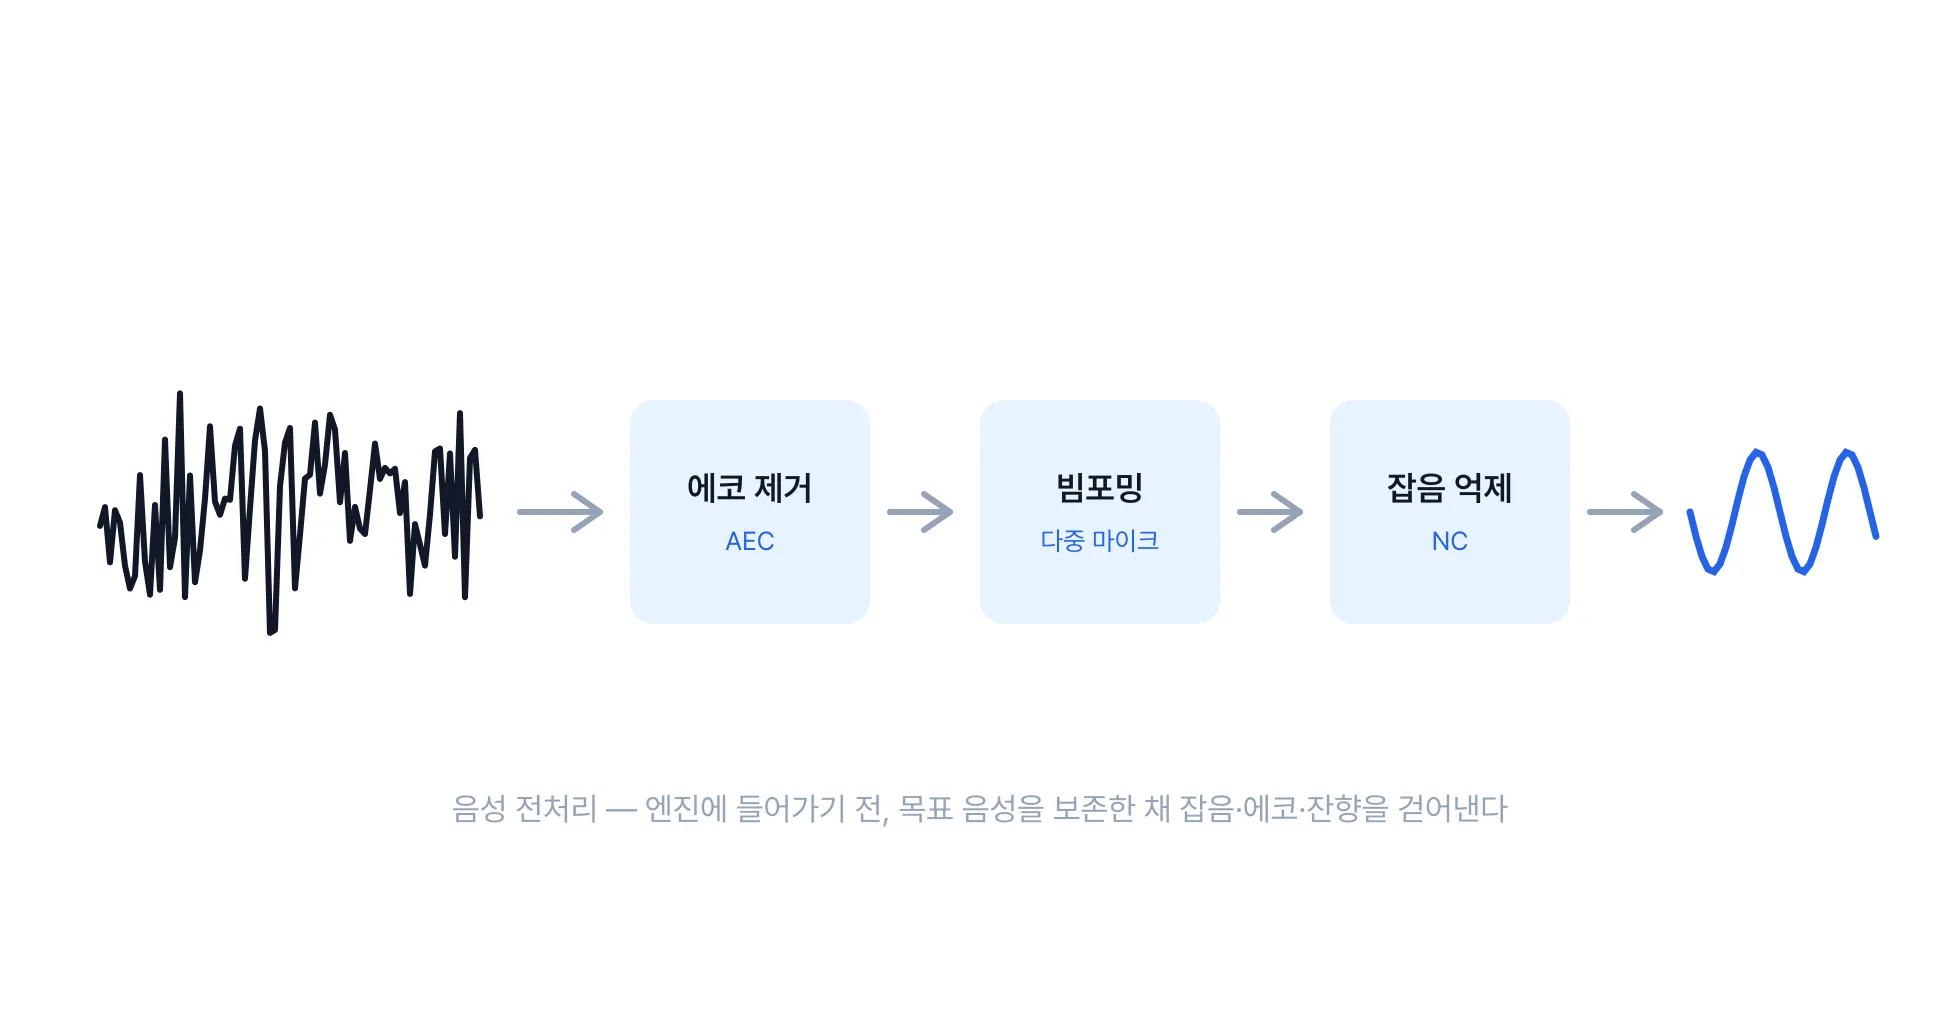
세 가지가 기본입니다. 순서대로 에코 제거, 빔포밍, 잡음 억제입니다.
- 에코 제거(AEC) — 제품 스피커에서 나간 소리가 마이크로 되돌아온 것을 걷어냅니다. 스피커로 보낸 신호를 참조 채널로 함께 받아야 동작합니다. 안내음 도중에 사용자가 말하는 제품에서 가장 먼저 필요합니다. → mpAEC
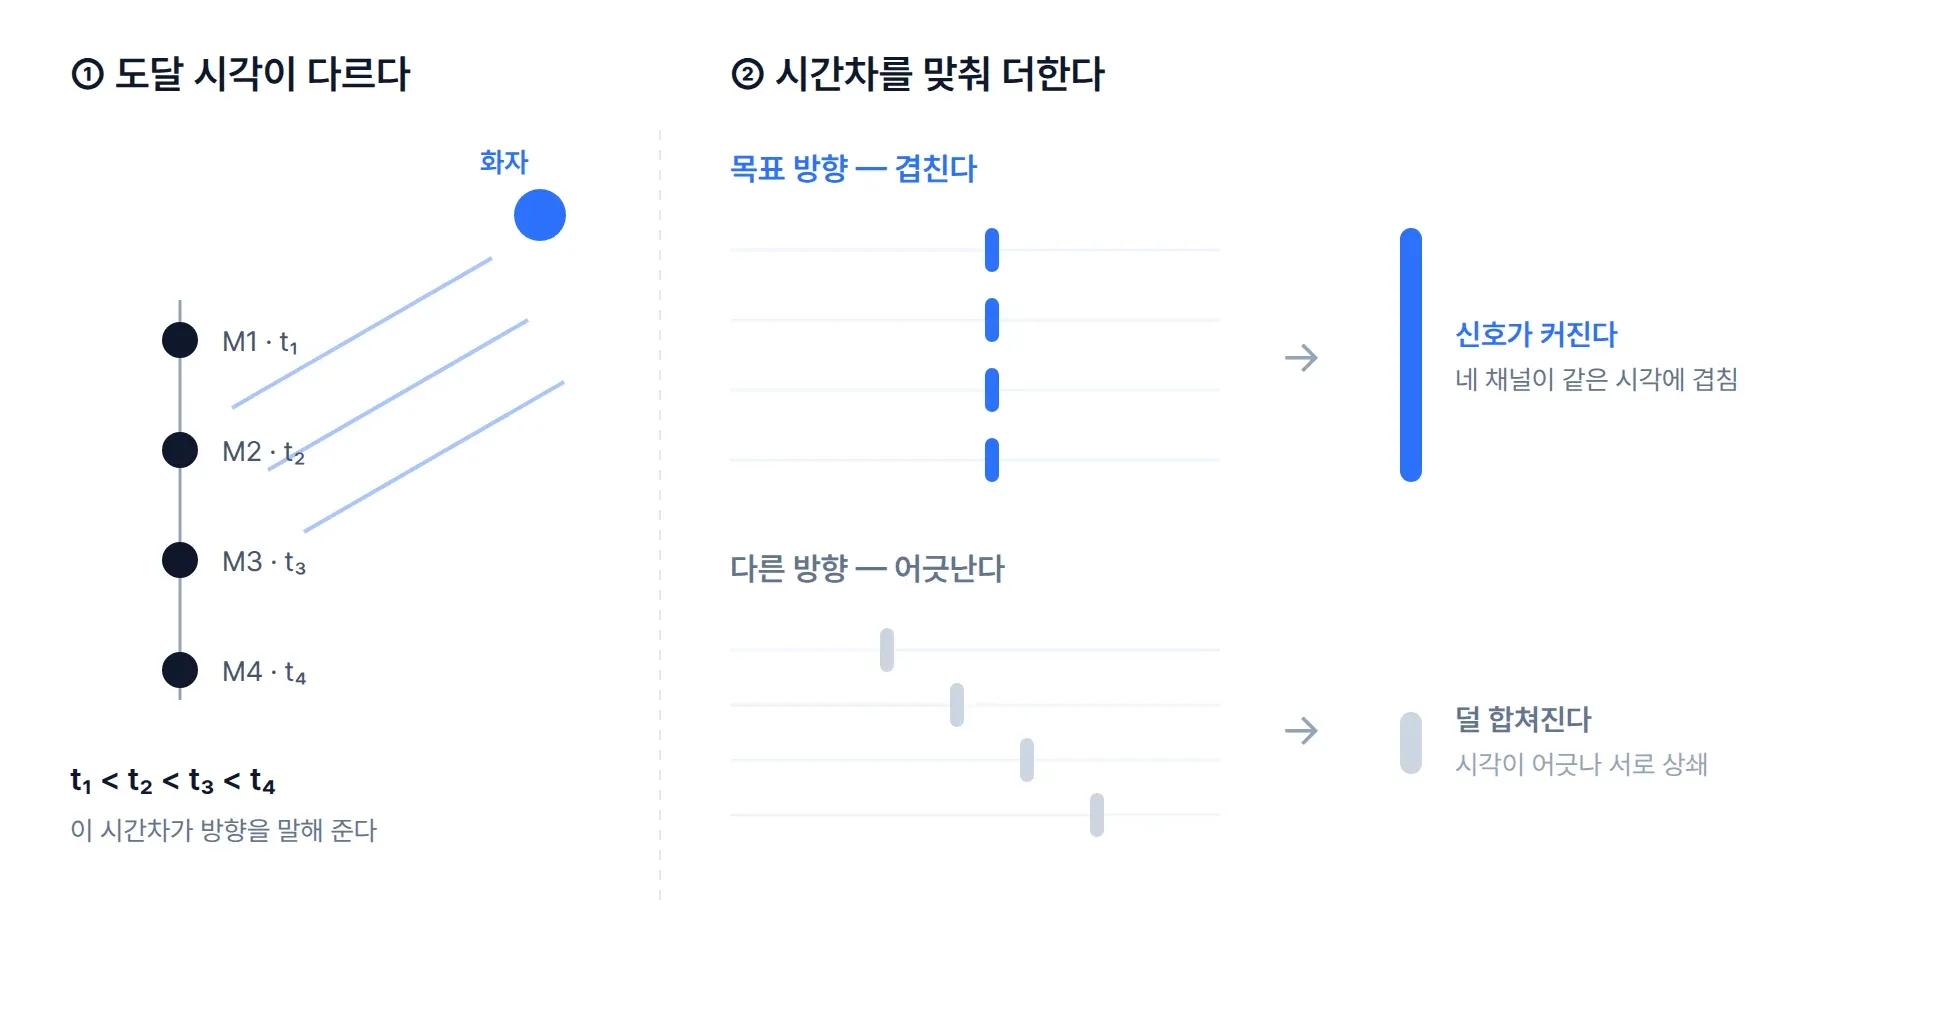
- 빔포밍 — 마이크가 두 개 이상일 때, 마이크 간 도달 시간차로 목표 화자 방향의 소리를 모으고 다른 방향의 성분을 줄입니다 [2]. 원리는 빔포밍이란?에 있습니다. → mpBeamforming
- 잡음 억제 — 남은 배경 잡음을 줄입니다. 마이크가 하나뿐인 제품에서는 이것이 유일한 수단입니다 [3]. → mpNC
같은 것을 부르는 이름이 여럿입니다. 학계에서는 음성 향상(speech enhancement), 음성인식 제품 쪽에서는 음향 프런트엔드(acoustic front end, AFE), 통화 제품에서는 노이즈 서프레션(noise suppression)이라고 부릅니다. 강조하는 지점이 조금씩 다를 뿐 엔진 앞단의 신호 처리라는 자리는 같습니다. 이 사이트에서는 ‘음성 전처리’로 통일합니다.
음성인식용 오디오 전처리는 어떻게 구성해야 하나요?
네 가지를 정하면 구성이 정해집니다. 마이크 수 — 하나면 잡음 억제(mpNC), 둘 이상이면 빔포밍이 더해집니다. 스피커 유무 — 제품이 소리를 내면 에코 제거가 먼저 들어가고 참조 채널이 필요합니다. 실행 위치 — 전처리는 대개 기기 안에서 돌립니다. 지연이 없고 원본 음성이 밖으로 나가지 않기 때문입니다. 인식까지 기기에서 할지, 전처리만 기기에서 하고 인식은 클라우드로 보낼지는 온디바이스와 클라우드 글에서 가릅니다. 연산 자원 — 전처리는 저사양 MCU·DSP에서 전용 NPU 없이 실시간으로 도는 것을 목표로 하고, 실측 동작 환경은 홈의 성능 표에 시험 조건과 함께 있습니다.
에코와 잡음이 함께 있는 제품 — 로봇, 키오스크, 차량이 대개 그렇습니다 — 에서는 에코 제거와 빔포밍을 따로 이어 붙이는 대신 하나로 최적화한 통합 처리를 씁니다. mpWAV에서는 그것이 mpAB입니다.
이미 만든 음성인식 시스템에도 적용할 수 있는가
네. 전처리는 마이크와 엔진 사이에 들어가고 엔진의 입력 형식을 바꾸지 않으므로, 이미 구축한 시스템의 앞단에 붙입니다. 상용 API를 쓰든 자체 엔진을 쓰든 같습니다. 붙인 뒤에는 같은 엔진·같은 녹음으로 전후를 비교해 효과를 따로 확인할 수 있고, 그 절차가 PoC입니다.
자주 묻는 질문
음성인식 엔진을 교체해야 하나요?
아니요. 전처리는 엔진 앞단에서 입력만 바꾸므로 쓰던 엔진을 그대로 둡니다. 재학습이 필요 없는 조건과 필요해지는 조건은 별도 글에 정리했습니다.
전처리를 넣으면 지연이 늘어나지 않나요?
실시간 조건(1초 음성을 1초 안에 처리) 안에서 동작하도록 만들며, 밀리초 단위의 추가 지연은 프레임 길이와 실행 플랫폼에 따라 달라 PoC에서 목표 플랫폼으로 직접 잽니다. 실측 처리인수는 기술 페이지 FAQ에 시험 조건과 함께 있습니다.
이어폰의 노이즈 캔슬링(ANC)과 같은 것인가요?
다릅니다. 이어폰의 ANC는 사람 귀에 들리는 주변 소음을 반대 위상의 소리로 상쇄하는 기술이고, 음성 전처리는 마이크로 들어온 신호에서 인식 엔진에 줄 음성을 골라내는 기술입니다. 대상도(귀 vs 엔진) 방법도(상쇄 vs 신호 분리) 다릅니다.
참고자료
- [1] J. Li, L. Deng, Y. Gong, and R. Haeb-Umbach, 「An Overview of Noise-Robust Automatic Speech Recognition」, IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 22, no. 4, 2014
- [2] J. Benesty, J. Chen, and Y. Huang, 「Microphone Array Signal Processing」, Springer, 2008
- [3] P. C. Loizou, 「Speech Enhancement: Theory and Practice」, 2nd ed., CRC Press, 2013